运维人员应掌握的香港cera高防服务器日常监控与故障处理方法
在管理香港cera高防服务器时,运维人员首先要权衡三项核心需求:最重要的是保障业务连续性,做到可观测与自动化响应;最好的是选用成熟的监控+告警+防护体系(如Prometheus+Grafana+WAF/抗DDoS服务);而最便宜的短期方案通常是结合云或CDN厂商的按需防护与基本监控,尽量用自动脚本与现成SaaS减少人工成本。
日常监控应覆盖四大面向:系统资源(CPU、内存、磁盘)、网络流量与包速率、应用/服务可用性(Web、数据库、缓存)以及安全事件(异常连接、指纹化攻击、入侵检测)。将这些指标通过统一平台采集、可视化并设定分级告警,是运维的第一道防线。
对高防服务器,网络相关指标优先级更高:带宽使用率、pps(包/秒)、连接数、异常突增流量/源IP分布。同时关注系统指标:load、IO等待、磁盘使用率与inode、应用响应时间与错误率(5xx)。定期记录并建立基线,便于识别异常。
推荐使用成熟监控栈(Prometheus+Grafana、Zabbix、Nagios)配合日志聚合(ELK/EFK或Splunk)。日志应包含系统日志、Web/应用日志、WAF与防护设备日志,做到集中查询与关联告警,便于在故障发生时快速定位。
建立明确的告警等级:信息/警告/紧急。低级告警用于趋势监控,高级告警(如流量突增、服务不可达)触发自动化脚本或值班人员介入。告警内容要包含影响范围、可能原因与初步处置建议,减少人工判断时间。
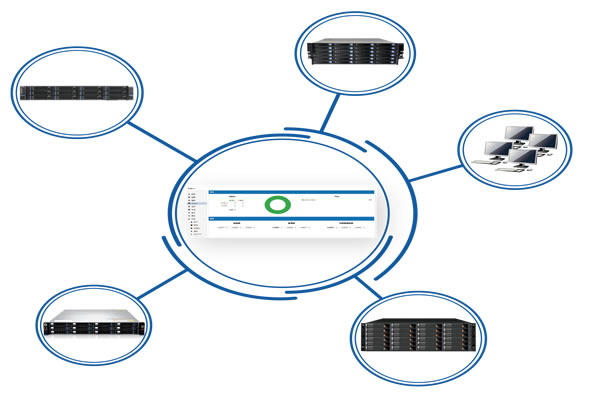
遇到网络异常先判断是链路、上游还是主机:查看网络接口速率、路由表、BGP状态(如适用)、以及防护设备抛弃规则。若是DDoS式突发,先通过流量清洗/流量切换到scrubbing/启用黑洞或CDN防护,阻断异常源并保持业务基本可用。
服务不可用时,按步骤排查:确认进程/服务是否存活、端口监听、依赖服务(数据库、缓存)状态、最近发布或配置变更、以及系统资源是否耗尽。必要时回滚到最近稳定版本或启用备用节点。
日志分析优先从异常时间点往回溯,定位错误码与堆栈。抓包用于确认网络层面是否有异常流量或协议畸形,但抓包应在合规前提下进行,避免泄露敏感信息。对DDOS类型问题,抓包用于识别攻击签名与源分布。
结合主机防护(防火墙、fail2ban、连接限制)、应用防护(WAF、速率限制、验证码)与网络层防护(ISP/机房的抗DDoS服务、BGP黑洞、流量清洗)。日常需验证防护规则是否覆盖新业务端点,并定期演练。
对香港cera高防服务器而言,自动化恢复(如自动重启服务、流量切换、黑名单下发)能显著缩短故障恢复时间。定期进行故障演练(包括DDoS演练、单点失效演练)能检验预案有效性并提升团队协作速度。
基于历史监控数据做容量预测,提前扩容或预留防护带宽。性能优化包括数据库索引、缓存命中率提升、静态资源上CDN、连接池调整等,能减少单机压力并降低在攻击窗口内的故障风险。
遇到大规模攻击或机房层面故障,及时联系机房/抗DDoS厂商并提供必要日志、时间线与流量样本。事先约定联动流程与SLA,明确谁负责切流、清洗与回滚,避免临时协调耗时。
每次故障结束后要做事后分析(Postmortem),记录根因、处置过程与改进措施。将经验转为自动化脚本、监控规则或运行手册,逐步降低同类故障发生率与恢复时间。
运维人员管理香港cera高防服务器需在日常监控、应急响应与防护策略间找到平衡。把握三点:建立可观测平台、制定可执行的分级预案、并与厂商保持良好联动。通过自动化与演练将“最好”方案逐步落地,同时结合云/CDN按需防护,达到成本与可靠性的最优组合。
-
CN2香港VPS:高防服务器提供者
CN2香港VPS:高防服务器提供者 CN2香港VPS作为一家专业的高防服务器提供者,在网络安全领域具有很高的知名度和口碑。他们提供的服务包括虚拟专用服务器(VPS),以及针对DDoS攻击的高防护措施。 CN2香港VPS的优势主要体现在网络速度、数据安全和客户服务方面。首先,他们使用CN2直连线路,确保网络速度快、稳定,适合2025年5月9日 -

百度搜索香港高防服务器时你需要了解的事项
问题一:什么是香港高防服务器? 香港高防服务器是指在香港地区提供的具有强大防护能力的服务器。这类服务器主要用于抵御各种网络攻击,例如DDoS攻击、CC攻击等。高防服务器通常配备了专业的防火墙、流量清洗设备以及其他安全措施,以确保用户网站或应用的稳定性和安全性。 问题二:为什么选择香港高防服务器? 选择香港高防服务器的原因主要有以下几点:2025年8月21日 -

探索香港高防绕美服务器的流量优化方案
1. 引言 在当今互联网环境中,服务器的选择对于企业的在线表现至关重要。尤其是对于需要高安全性和稳定性的业务,香港高防绕美服务器成为了一个理想的选择。本文将深入探讨香港高防绕美服务器的流量优化方案,帮助企业提升其在线服务的质量和效率。 2. 什么是香港高防绕美服务器 香港2025年11月29日 -
香港高防服务器防御方法分享
香港高防服务器防御方法分享 随着网络攻击日益增多,保护服务器安全变得尤为重要。香港高防服务器是一种具有强大抗攻击能力的服务器,但仍需采取一些措施来提高其安全性。 首先,加强防火墙设置是保护高防服务器的关键一步。确保防火墙规则设置严格,只允许必要的端口开放,并定期更新防火墙规则以应对新型攻击。 其次,定时更新服务器系统补丁也2025年6月30日 -
香港高防IPVPS:稳定、可靠的网络保障
香港高防IPVPS:稳定、可靠的网络保障 在当今数字化时代,互联网已经成为了人们生活和工作中不可或缺的一部分。然而,网络安全问题也随之而来。为了保护自己和企业的机密信息以及避免被黑客攻击,使用高防IPVPS是至关重要的。 在选择高防IPVPS时,香港是一个理想的选择。首先,香港拥有先进的网络基础设施和技术,提供高速、稳定的网络连2025年4月6日 -
香港高防不死服务器,保障网站安全稳定
香港高防不死服务器,保障网站安全稳定 高防不死服务器是一种具有强大的抗DDoS攻击能力的服务器。它能够有效地保护网站免受恶意攻击,确保网站的安全和稳定运行。 香港作为一个国际化大都市,拥有发达的互联网基础设施和严格的法律法规,为网站提供了良好的发展环境。香港高防不死服务器的优势在于其稳定可靠的性能,以及对DDoS攻击的高度抵抗2025年7月4日 -

企业为何优先选择香港 高防服务器作为亚太流量防护中枢
1.香港作为亚太流量防护中枢的战略价值 - 地理位置:毗邻大陆与东南亚,海底光缆密集,天然成为枢纽。 - 网络通达:大量IX与国际骨干链路,便于做BGP多线和Anycast部署。 - 法规与商业环境:成熟的数据中心与云服务商, SLA 与运维生态完善。 - 成本效益:带宽成本相对合理,能够采购到大口径清洗带宽。 - 综合理由:低延迟、强清洗能力2026年6月14日 -
香港高防表的可靠性
香港高防表的可靠性 随着互联网的迅猛发展,网络安全问题日益突出。在这个信息化时代,保护网站免受各种网络攻击的威胁变得至关重要。高防表作为一种有效的网络安全解决方案,受到了越来越多的关注。本文将探讨香港高防表的可靠性,以及它在保护网站安全方面的作用。 高防表是一种基于云2025年2月20日 -

选择高防香港云服务器时ISP优化与带宽策略的实战建议
核心摘要 在选择高防香港云服务器时,合理的ISP优化和带宽策略能直接决定业务稳定性与成本效率。优先考虑多线接入与BGP路由、弹性带宽与突发能力、以及与CDN和DDoS防御系统的深度联动。部署时应兼顾对内地访问的跨境优化、对等互联质量以及运营商时延/丢包表现。本篇给出可落地的评估项、带宽选型、流量清洗与回源策略,并推荐德讯电讯2026年8月2日