福田香港站群服务器稳定性和带宽选择实操建议及服务商比对
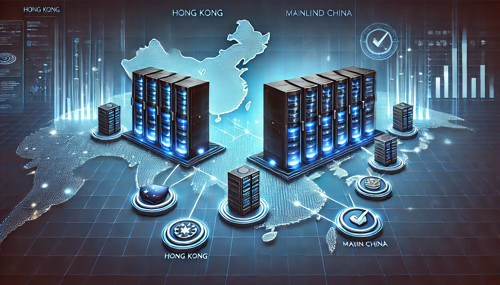
福田·香港站群落地:稳定与带宽的实操红线
1. 精华:优先保障稳定性(99.95%起)与多线BGP冗余,再谈带宽档位。
2. 精华:站群不是堆IP,合理拆分流量、使用CDN与反向代理能把费用降到一半且提升用户体验。
3. 精华:对比服务商比对要看SLA、抗DDoS能力、机房位置与本地带宽成本,而不是单看带宽价格。
如果你要在深圳福田接入或在香港建站群服务器,先抛弃“买最大带宽就稳”的迷思。真正的高可用来自于架构设计、链路冗余和实时监控。本文提供可操作的落地建议与常见服务商比对思路,帮助你在预算内把稳定性和响应速度做到极致。
一、稳定性的硬指标与落地做法。对站群服务器而言,建议把目标定在99.95%-99.99%之间;对于关键业务甚至要求99.995%。要达到这个目标,优先考虑:多机房冗余、双路电源和多线BGP出口。选择机房时,确认数据中心的Tier等级、UPS与柴油机组的测试记录、以及网络带宽是否为骨干直连或仅为转接链路。
二、带宽选择的实操逻辑。带宽不是越大越好,应当基于QPS、并发连接、单页面大小和并发下载峰值计算。常用量化方法:用iperf3或wrk在真实流量模拟下测压;估算公式:并发连接×平均响应大小/平均处理时间 = 带宽需求。对于常见站群场景,建议把流量分层:静态资源走CDN,动态API走负载均衡器,管理后台与爬虫流量单列策略,这样可把公网出口带宽需求显著下降。
三、抗DDoS与防护能力不可忽视。很多人忽略稳定性的主要威胁来自DDoS攻击。优选具备清洗中心或提供云端清洗服务的厂商,同时核查清洗带宽(清洗能力以Gbps或Tbps计)、SLA清洗时长与清洗阈值。大流量清洗能力可避免短时间内带宽耗尽导致的群站瘫痪。
四、测评工具与落地步骤(实操)。建议按以下步骤执行:1) 在目标机房做ping/mtr连续48小时监测链路丢包与抖动;2) 用iperf3测单流/多流带宽吞吐;3) 在业务高峰预测期做压力测试(wrk或ab);4) 部署Zabbix/Prometheus+Alertmanager做实时告警。所有测试数据需留档,作为与服务商比对和谈判SLA的证据。
五、站群专用的带宽采购策略。采购时考虑:峰值带宽 vs. 包月包流量 vs. 按使用计费。常见实操方案是:基线保底带宽+按峰值自动弹性计费,或者与厂商谈判“突发免费流量包”。同时,建议为不同站群分配独立出口或独立VLAN,避免单点流量风暴。
六、架构建议(经典组合)。推荐基础架构:边缘:CDN+Anycast DNS,中端:负载均衡器+反向代理,内核:多台应用节点+数据库主备;网络:双线或多线BGP,并在不同机房部署健康检查与自动切换脚本。对站群而言,IP多样性比单一大带宽更重要,尤其要避免单一运营商的链路瓶颈。
七、常见误区与纠正。误区一:买到大带宽就等于高速——错,仍需看链路质量与互联互通。误区二:所有流量都走一个出口——错,未分流将放大风险。误区三:忽视运维自动化——错,自动化能把宕机时间从小时缩到分钟级。
八、主流服务商比对要点(中立视角)。在香港及福田接入的常见选择包括:阿里云香港、腾讯云香港、AWS(香港区域ap-east-1)、Azure、Equinix/本地机房(PCCW/HKT/HGC)等。对比时关注:1) 本地骨干直连或国际链路(影响延迟);2) 抗DDoS清洗能力与价格;3) 机房互联延迟(到大陆、东南亚、欧美);4) SLA与运维响应时效;5) 费用模型(包年/按需/带宽包)。
九、服务商优缺点速览(实务参考)。阿里云/腾讯云:价格灵活、国内互联优势明显,但清洗细节需按规格确认;AWS/Azure:全球生态与高可用组件丰富,成本相对较高;Equinix/本地机房:适合需要直连多家运营商与混合云场景,成本和运维门槛高。务必根据你的目标流量分布和预算做权衡。
十、谈判与采购技巧。拿到报价后,要求服务商提供最近三个月的链路丢包/延迟报表、清洗案例与SLA文档;合同里写清楚清洗响应时间、清洗阈值、带宽计费精度与赔付条款。对长期项目可尝试谈折扣、免费试用期或带宽阶梯优惠。
十一、监控与运维Playbook(关键动作)。部署步骤:一键切换脚本、健康检查、流量阈值告警、流量溯源日志保留;同时定期演练故障切换(freeze test)。对站群,要把所有站点的异常访问集中到日志分析平台,用速率阈值触发自动隔离。
十二、结语:落地比理论更重要。选机房和带宽时不要被“单点最大值”诱惑,优先把稳定性、链路质量与清洗能力做成刚需;带宽通过架构优化与CDN分流来节省成本。最后,做足测试并把数据作为谈判武器,你会发现同样预算下能获得更靠谱的可用性。
如果你愿意,我可以基于你的具体流量情况(峰值并发、主要访问地域、预算)给出一套量化的带宽与机房配比方案,并把几家服务商比对写成可执行的采购清单。
-
考拉香港站微信群:连接你与香港购物的最佳社群
考拉香港站微信群:连接你与香港购物的最佳社群 考拉香港站微信群是一个由考拉海购创建的在线社群,旨在为用户提供与香港购物相关的信息和交流平台。无论您是香港购物的新手还是经验丰富的购物达人,加入我们的微信群将为您提供丰富的购物资源和交流机会。 考拉香港站微信群作为连接您与香港购物的最佳社群,具有以下几个亮点:2025年1月28日 -
香港站群服务器试用:提升您的网站排名
在当今数字化时代,拥有一个高排名的网站对于任何企业来说都至关重要。随着搜索引擎优化(SEO)的发展,网站站群已经成为提升排名的一种有效策略。而香港站群服务器的试用则是实现这一目标的理想选择。 站群服务器是指托管多个网站的服务器,这些网站通常属于同一主人或同一业主。通过站群服务器,您可以将多个网站集中管理,统一优化,提高它们在搜索引擎中的排2025年2月11日 -
香港站群优惠活动限时抢购
香港站群优惠活动限时抢购 香港站群是一个集合了多个网站的平台,为用户提供了更便捷、高效的服务。现在,香港站群推出了限时抢购优惠活动,让您享受更多优惠和实惠。不容错过!2025年6月10日 -
最佳服务器选择:找寻适合香港站群的最佳服务器
最佳服务器选择:找寻适合香港站群的最佳服务器 在建立香港站群时,选择适合的服务器是至关重要的。一个高性能、稳定可靠的服务器可以提供更好的用户体验,同时也能提高网站的排名。本文将介绍如何找寻适合香港站群的最佳服务器。 首先,选择距离香港较近的服务器位置是非常重要的。服务器的物理位置与访问速度直接相关。选择香港附近的服务器可以最大限2025年3月24日 -
香港站群服务器IP连段:提供稳定的多IP地址选择
香港站群服务器IP连段:提供稳定的多IP地址选择 随着互联网的快速发展,越来越多的企业开始意识到网站建设和优化的重要性。而在进行站群建设时,选择一个稳定的多IP地址的服务器是至关重要的。本文将介绍香港站群服务器IP连段的特点及其提供的稳定的多IP地址选择。 香港站群服务器IP连段是指在香港地区的服务器提供商所提供的一种服务,其2025年4月18日 -
强大的服务器香港站群8C,助您快速打开网络商机
强大的服务器香港站群8C,助您快速打开网络商机 随着互联网的不断发展,网络商机变得越来越重要。而拥有一台强大的服务器是开展网络商机的基础。本文将介绍香港站群8C服务器的优势,帮助您快速打开网络商机。 香港站群8C服务器是一种高性能、高可靠的服务器,具有以下优势: 性能强劲:香港站群8C服务器配备了强大的处理器和大容2025年7月18日 -
香港站群服务器优化方案对SEO的影响分析
本文将深入探讨香港站群服务器优化方案如何对SEO产生积极影响,分析其对网站速度、稳定性、以及搜索引擎排名的作用。选择合适的服务器提供商,如德讯电讯,能够有效提升网站的访问速度和用户体验,从而提高SEO效果。 选择合适的服务器对SEO的重要性 在进行网站优化时,选择合适的服务器至关重要。香港站群服务器不仅可以提高网站的访问速度,还能够优化用户体2025年9月24日 -
香港站群营销报价:提供高效SEO服务
在当今数字时代,拥有一个强大的在线存在是企业成功的关键。为了在竞争激烈的市场中脱颖而出,企业需要有效的SEO策略来提高其在搜索引擎结果中的排名。香港站群营销是一家提供高效SEO服务的专业机构,我们为客户提供全面的解决方案,以帮助他们在搜索引擎中获得更高的曝光度和流量。 香港站群营销专注于为客户提供高效的SEO服务。我们的核心服务包括:2025年3月30日 -
搭建便宜香港站群的最佳选择
搭建便宜香港站群的最佳选择 在当今数字化时代,网站的存在至关重要。通过建立站群,可以更好地展示您的产品和服务,吸引更多的客户。但是,要想搭建一个具有稳定性和性价比的站群并不容易,尤其对于想要面向香港市场的用户来说。在本文中,我们将介绍如何选择搭建便宜香港站群的最佳选择。 搭建站群首先需要选择一个合适的主机服务商。在选择主机服务2025年6月23日